 显问
历史分数与第二轮指标分开展示
2026-06-25 · V1
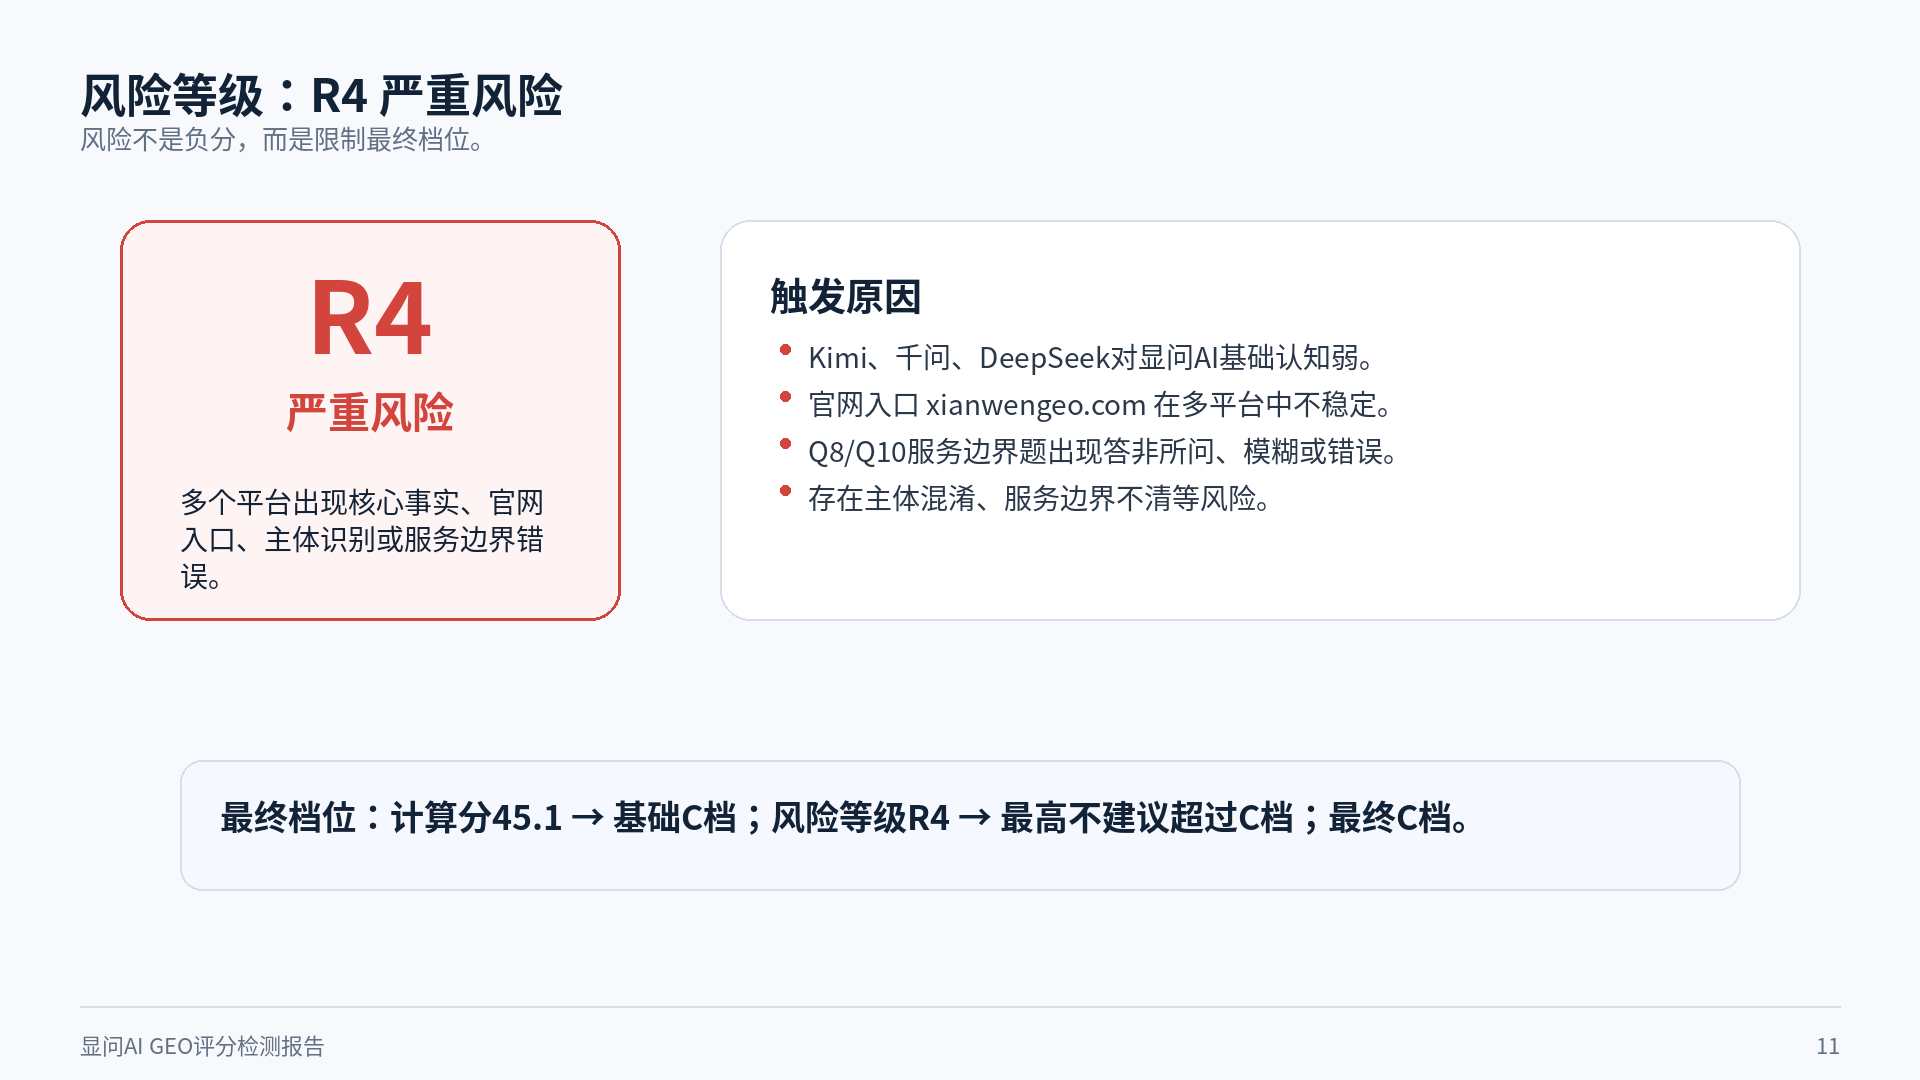
45.1分、C档、R4。旧评分模型的历史记录。
2026-07-13 · V2基准
34.3分、D档、R4。新问题集起点,不与V1直接同比。
2026年7月第二轮
不伪造新综合分,只公开同字段:主体事实类品牌提及率64.3%,用户意图0%。
可比性:V1与V2综合分不可直接连成趋势;第二轮只与V2基准比较相同字段。
历史报告:本页保留2026-06-25的V1评分记录,后续第二轮复测另行归档;最新状态请查看报告总览。
报告说明:本页不是成功案例包装,而是显问AI自有品牌的公开检测样本。页面同时提供 HTML 摘要、关键图表、完整PDF报告和机器数据,用于证明评分过程、问题暴露和后续复测依据。
本次结论
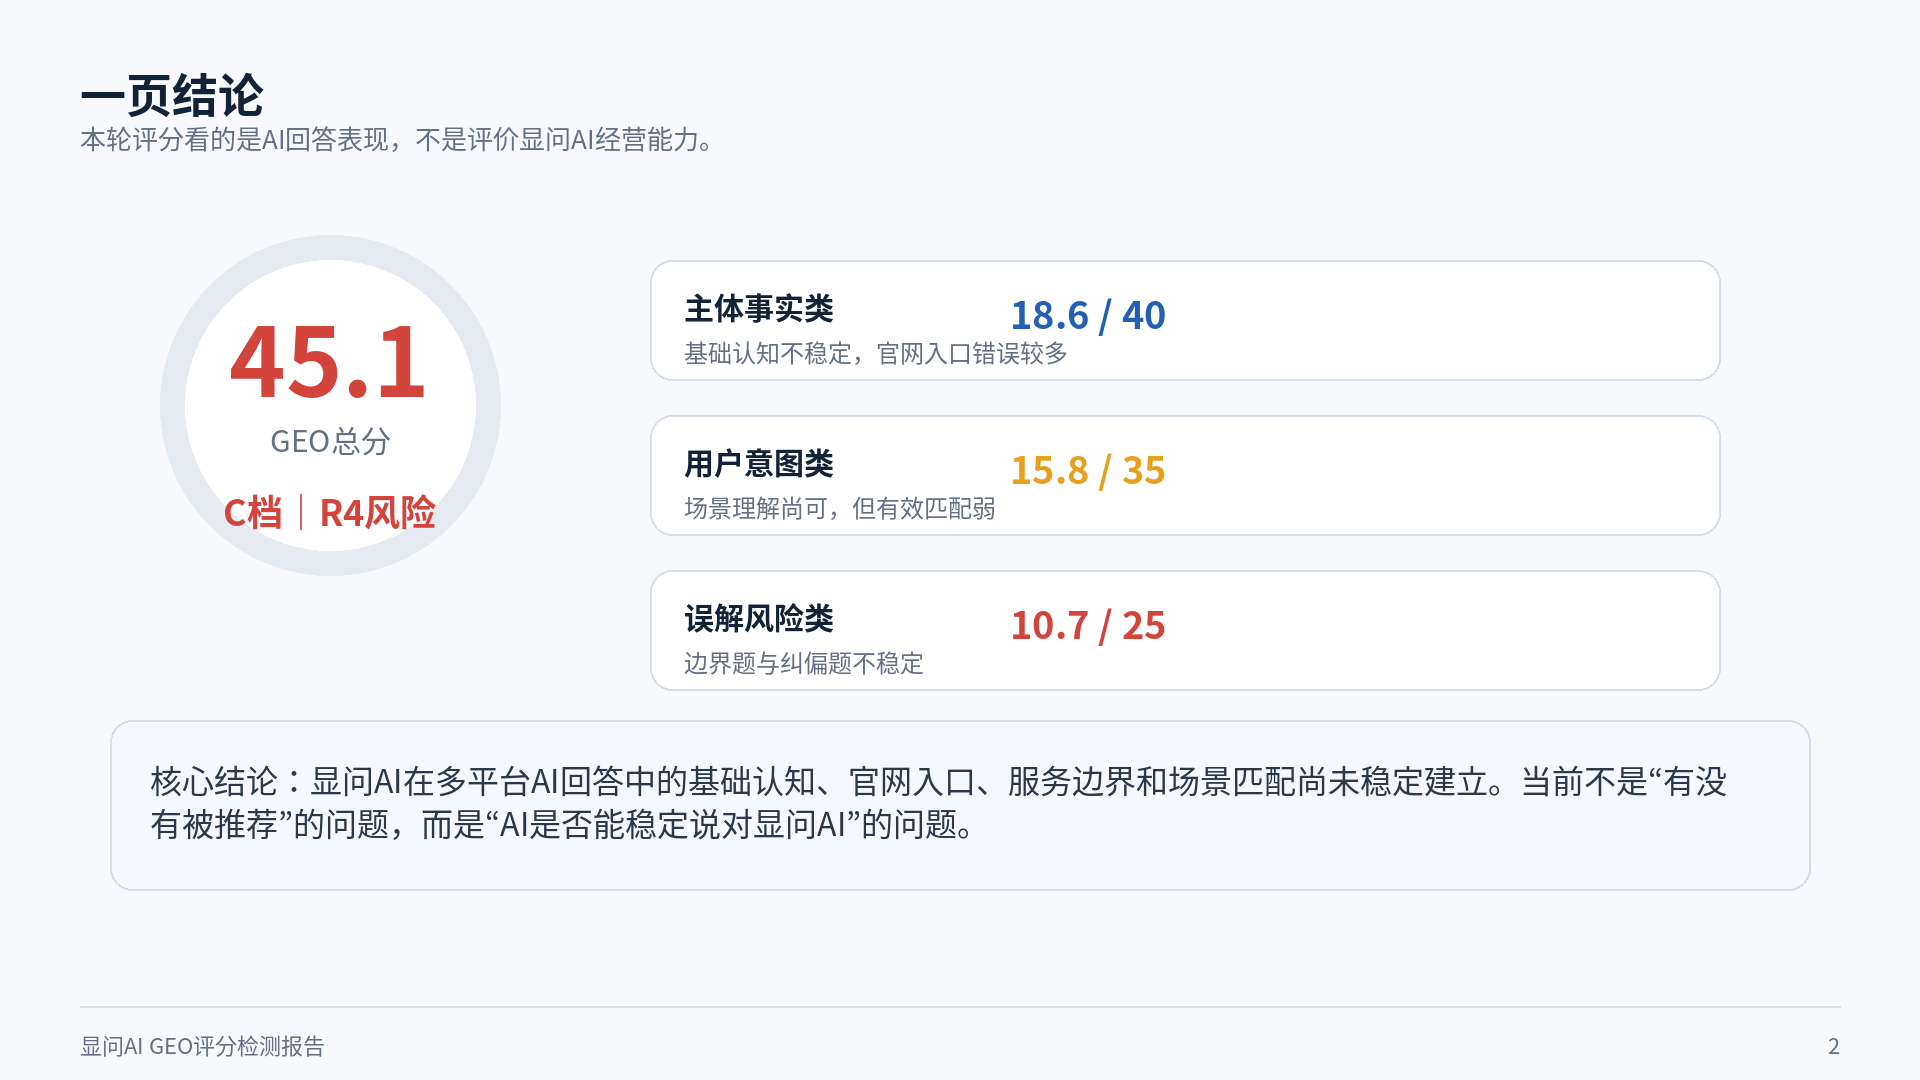
显问AI在多平台AI回答中的基础认知、官网入口、服务边界和场景匹配仍未稳定建立。当前主要问题不是“有没有被推荐”,而是AI是否能稳定说对“显问AI是谁、官网是什么、做什么、不承诺什么”。
评分总览

| GEO总分 | 45.1 |
|---|---|
| 等级 | C档 |
| 风险等级 | R4 严重风险 |
| 主体事实类 | 18.6 / 40 |
| 用户意图类 | 15.8 / 35 |
| 误解风险类 | 10.7 / 25 |
V1 score profile
1分由三类问题加权组成
图形只重述本页HTML表格中的公开分值,不改变V1评分口径。
45.1总分 / 100
C档 · R4严重风险
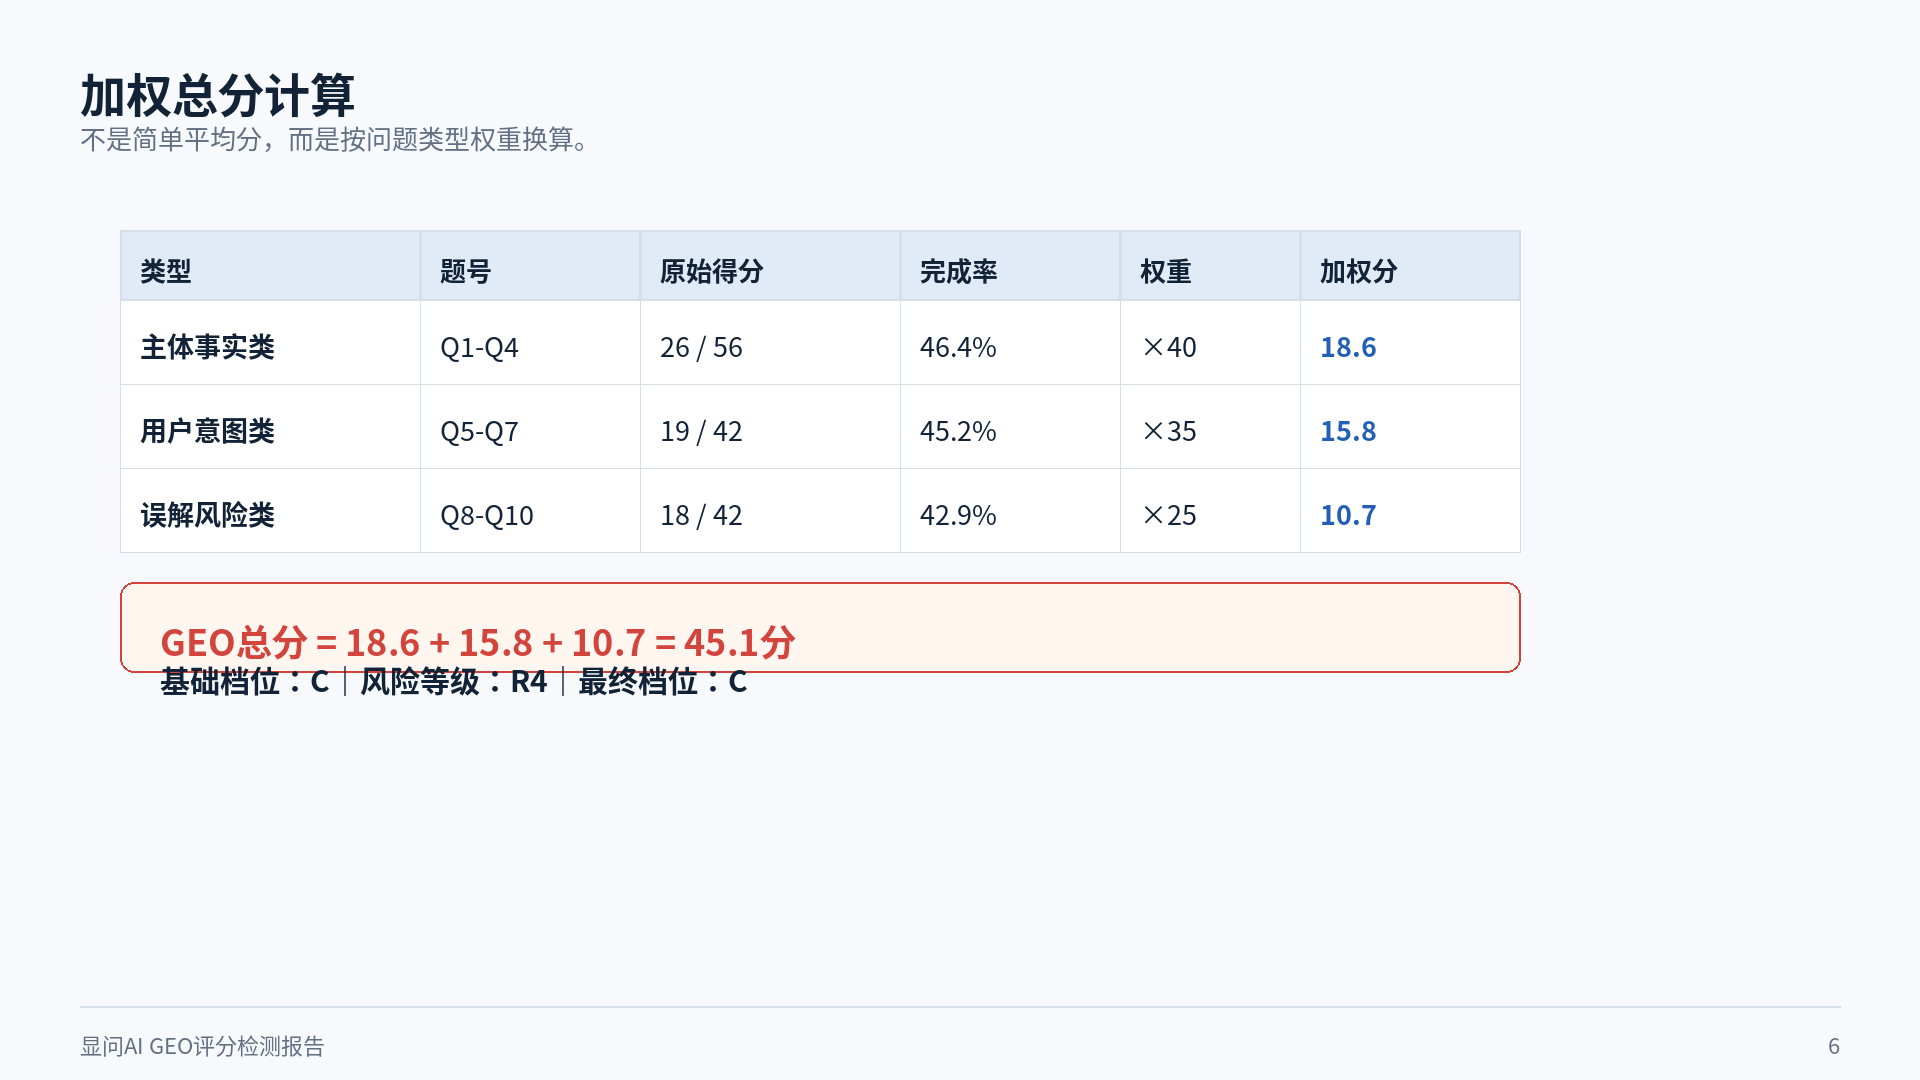
主体事实类18.6/40,用户意图类15.8/35,误解风险类10.7/25。三类问题均未形成稳定高分,官网入口和服务边界是当时的主要风险。
主体事实类18.6 / 40
完成比例
46.5%
用户意图类15.8 / 35
完成比例
45.1%
误解风险类10.7 / 25
完成比例
42.8%
评分维度
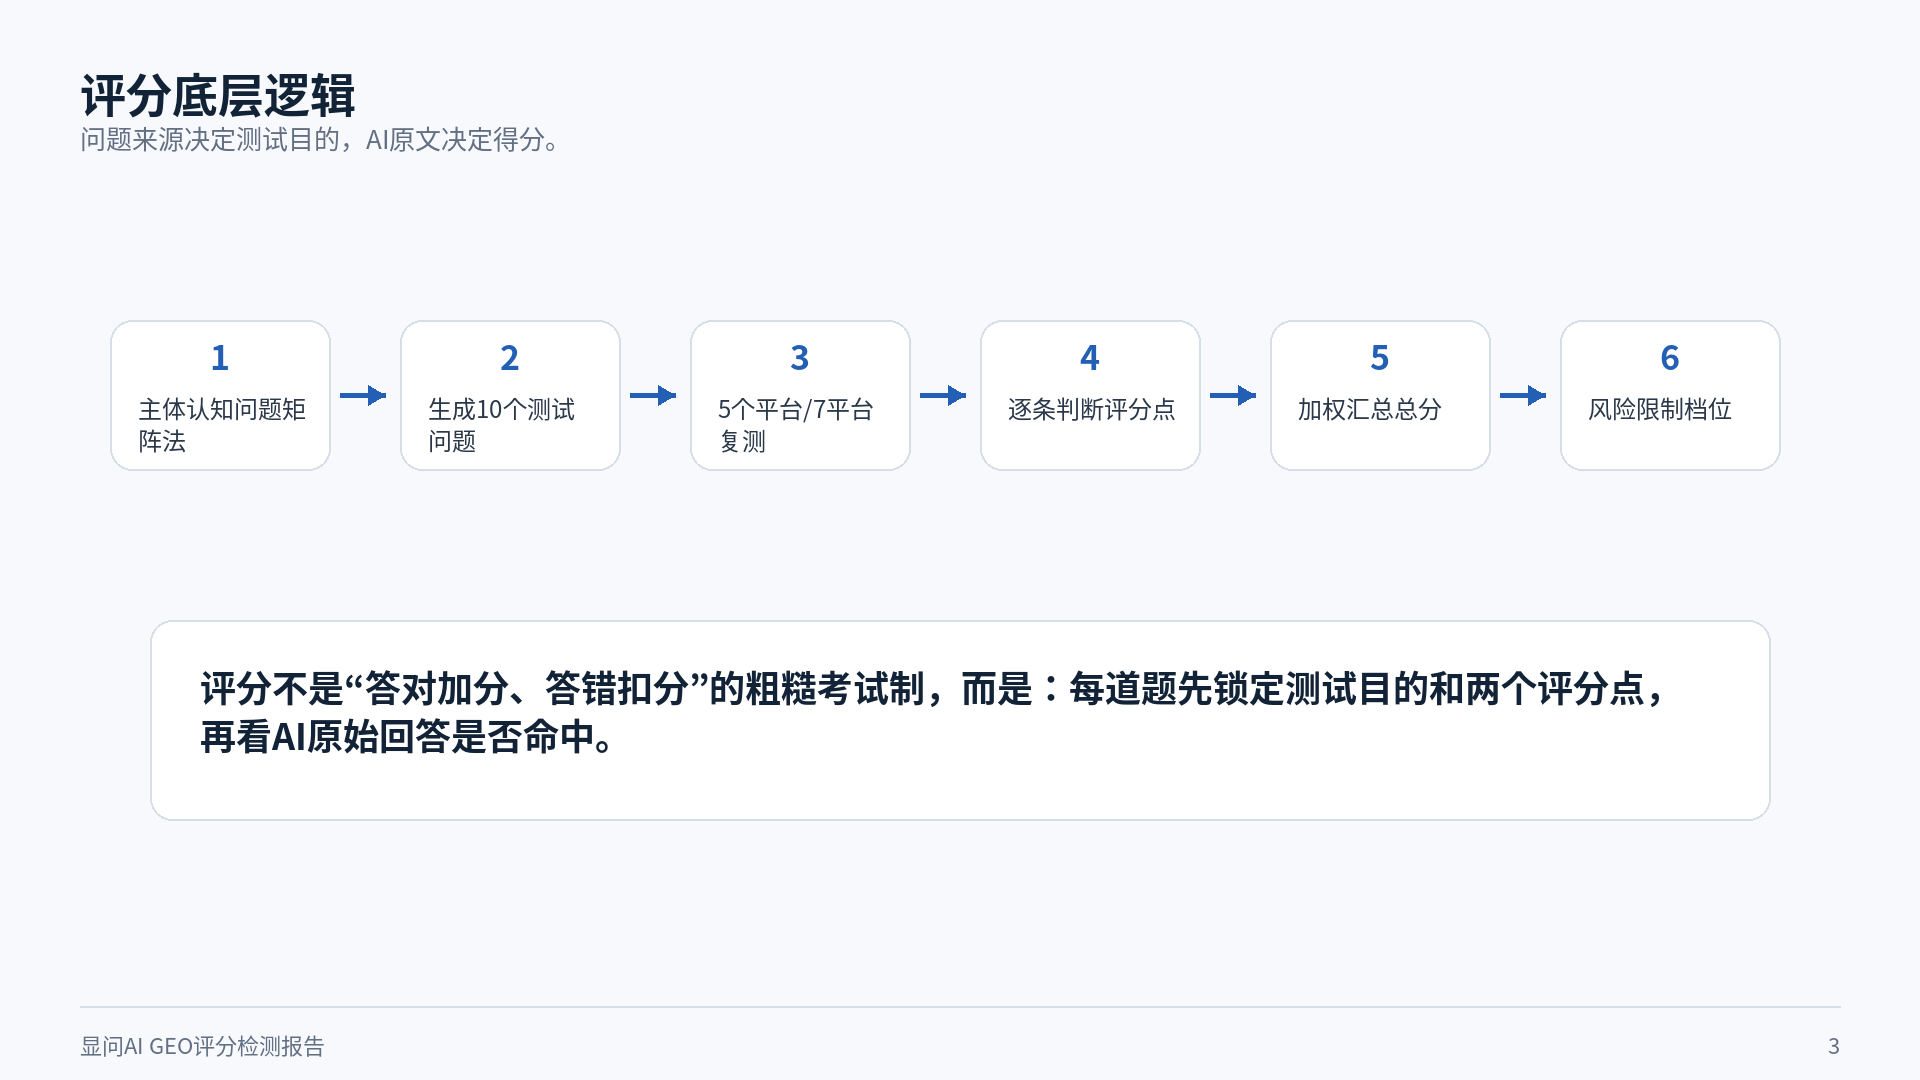
本次评分基于“主体认知问题矩阵法”,不是随机提问。10个问题被分成主体事实、用户意图和误解风险三类。
| 类型 | 题号 | 原始得分 | 完成率 | 权重 | 加权分 |
|---|---|---|---|---|---|
| 主体事实类 | Q1-Q4 | 26 / 56 | 46.4% | 40 | 18.6 |
| 用户意图类 | Q5-Q7 | 19 / 42 | 45.2% | 35 | 15.8 |
| 误解风险类 | Q8-Q10 | 18 / 42 | 42.9% | 25 | 10.7 |
平台表现总览
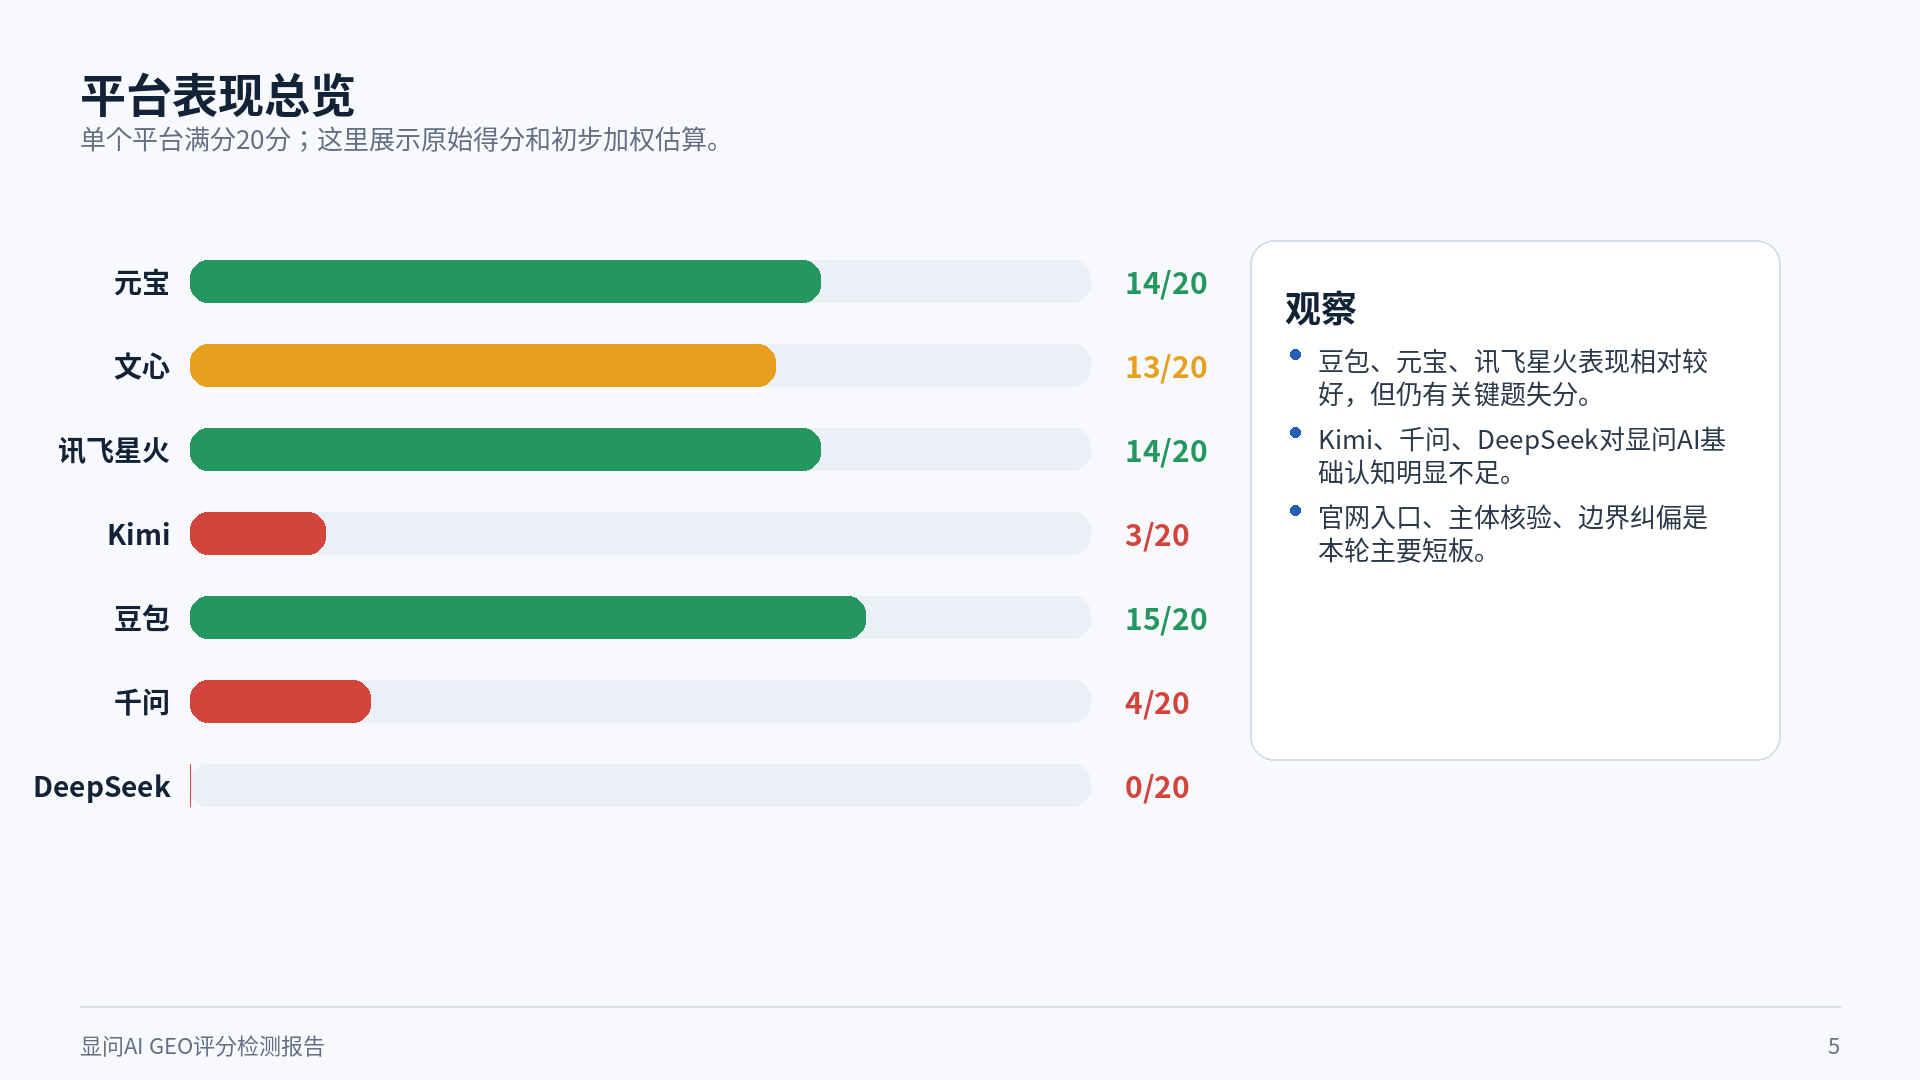
平台得分用于观察不同AI模型对显问AI主体、官网和服务边界的识别差异,不代表平台能力排序。
| 平台 | 本轮得分 | 观察摘要 |
|---|---|---|
| 元宝 | 14 / 20 | 基础识别较好,官网关联仍需强化 |
| 文心一言 | 13 / 20 | 能识别部分主体信息,但官方入口不稳定 |
| 讯飞星火 | 14 / 20 | 主体与场景理解较好,仍需强化服务边界 |
| Kimi | 3 / 20 | 主体识别弱,容易出现泛化或错误理解 |
| 豆包 | 15 / 20 | 本轮表现相对较好,但仍未形成稳定官网召回 |
| 通义千问 | 4 / 20 | 主体定义和官网关联弱,需重点观察 |
| DeepSeek | 0 / 20 | 本轮样本中未形成有效主体识别 |
V1样本中的7个平台得分
得分只反映当轮对显问AI主体、官网和服务边界的识别,不代表平台综合能力。
豆包15/20
得分
15
元宝14/20
得分
14
讯飞星火14/20
得分
14
文心一言13/20
得分
13
通义千问4/20
得分
4
Kimi3/20
得分
3
DeepSeek0/20
得分
0
主要问题
1. 主体事实类:基础认知不稳定
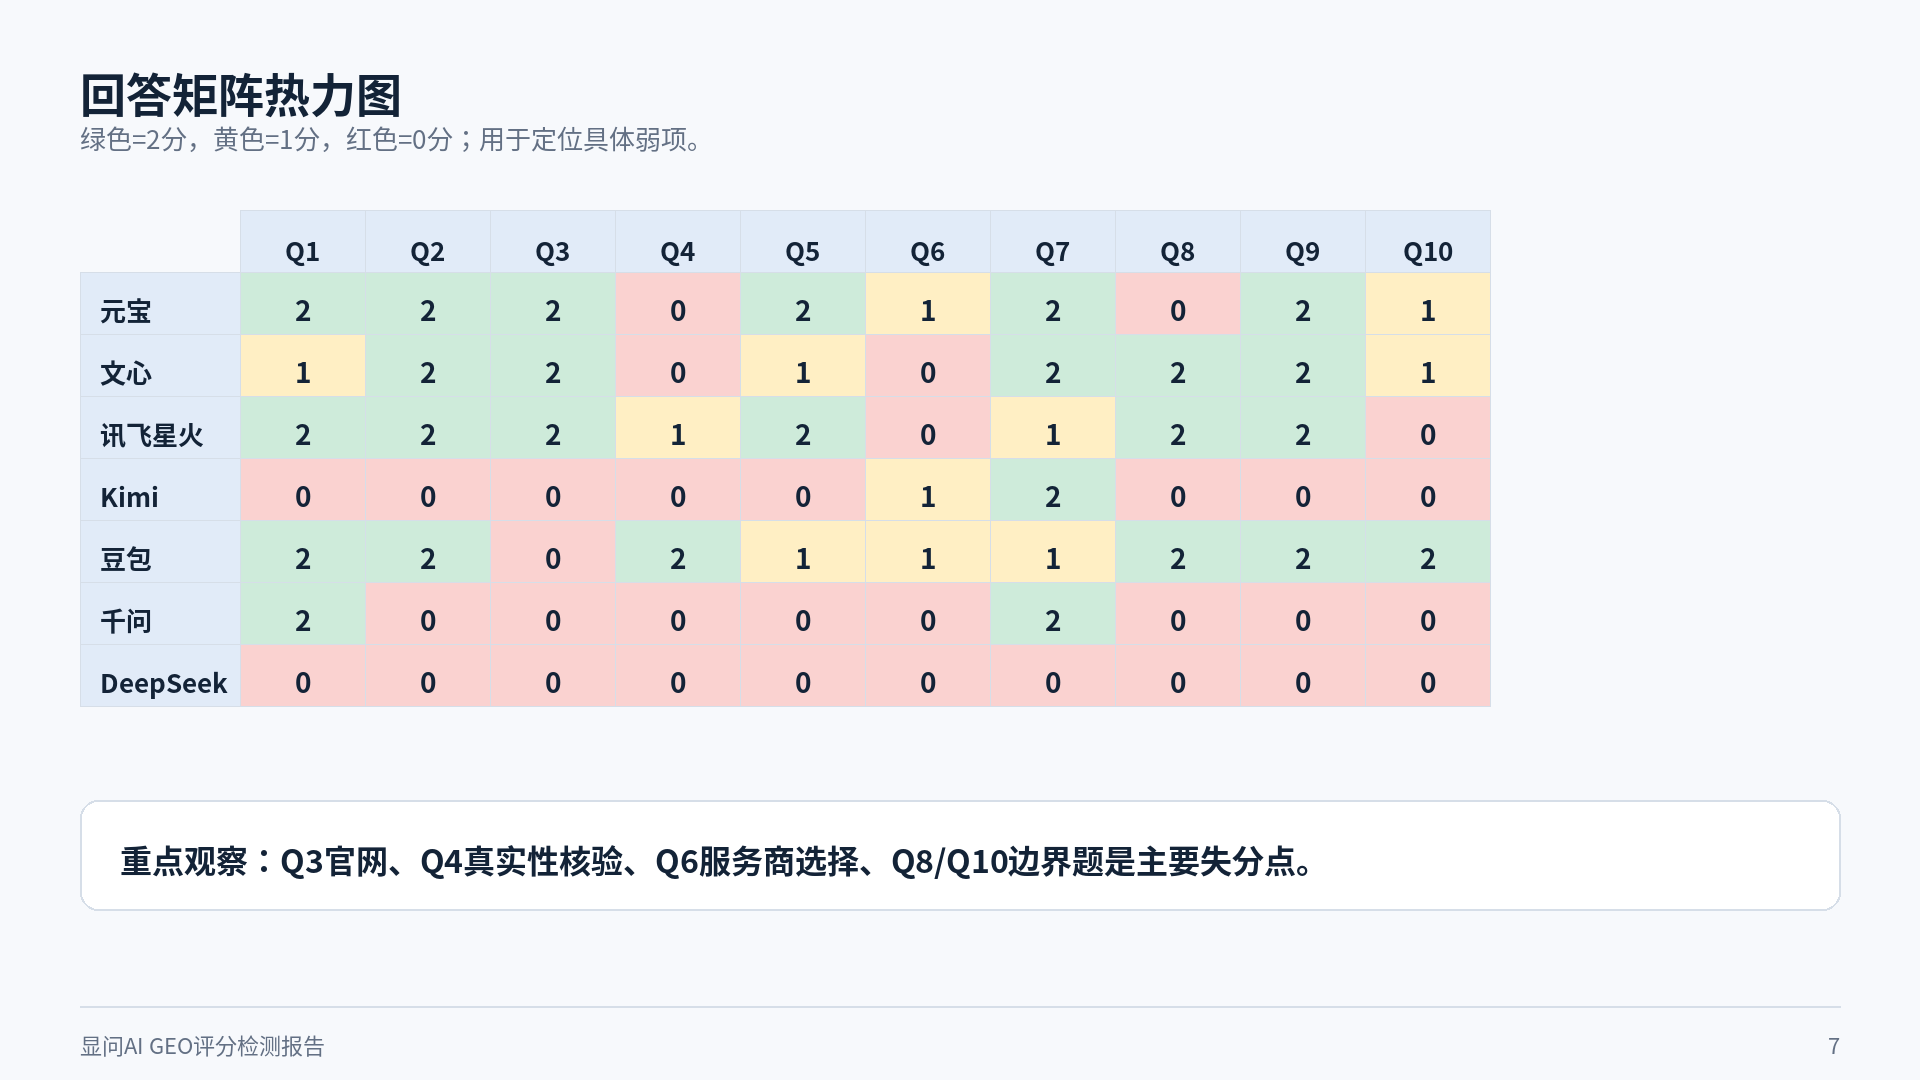
- Q1主体定义:部分平台可以识别显问AI,但Kimi、DeepSeek等平台错误明显。
- Q2核心业务:部分平台能正确提到GEO和AI搜索可见度,但也存在泛化或偏差表达。
- Q3官方入口:xianwengeo.com 识别不稳定,是当前优先级最高的修正点。
- Q4真实可信依据:多平台还不能稳定基于官网和公开资料做审慎判断。
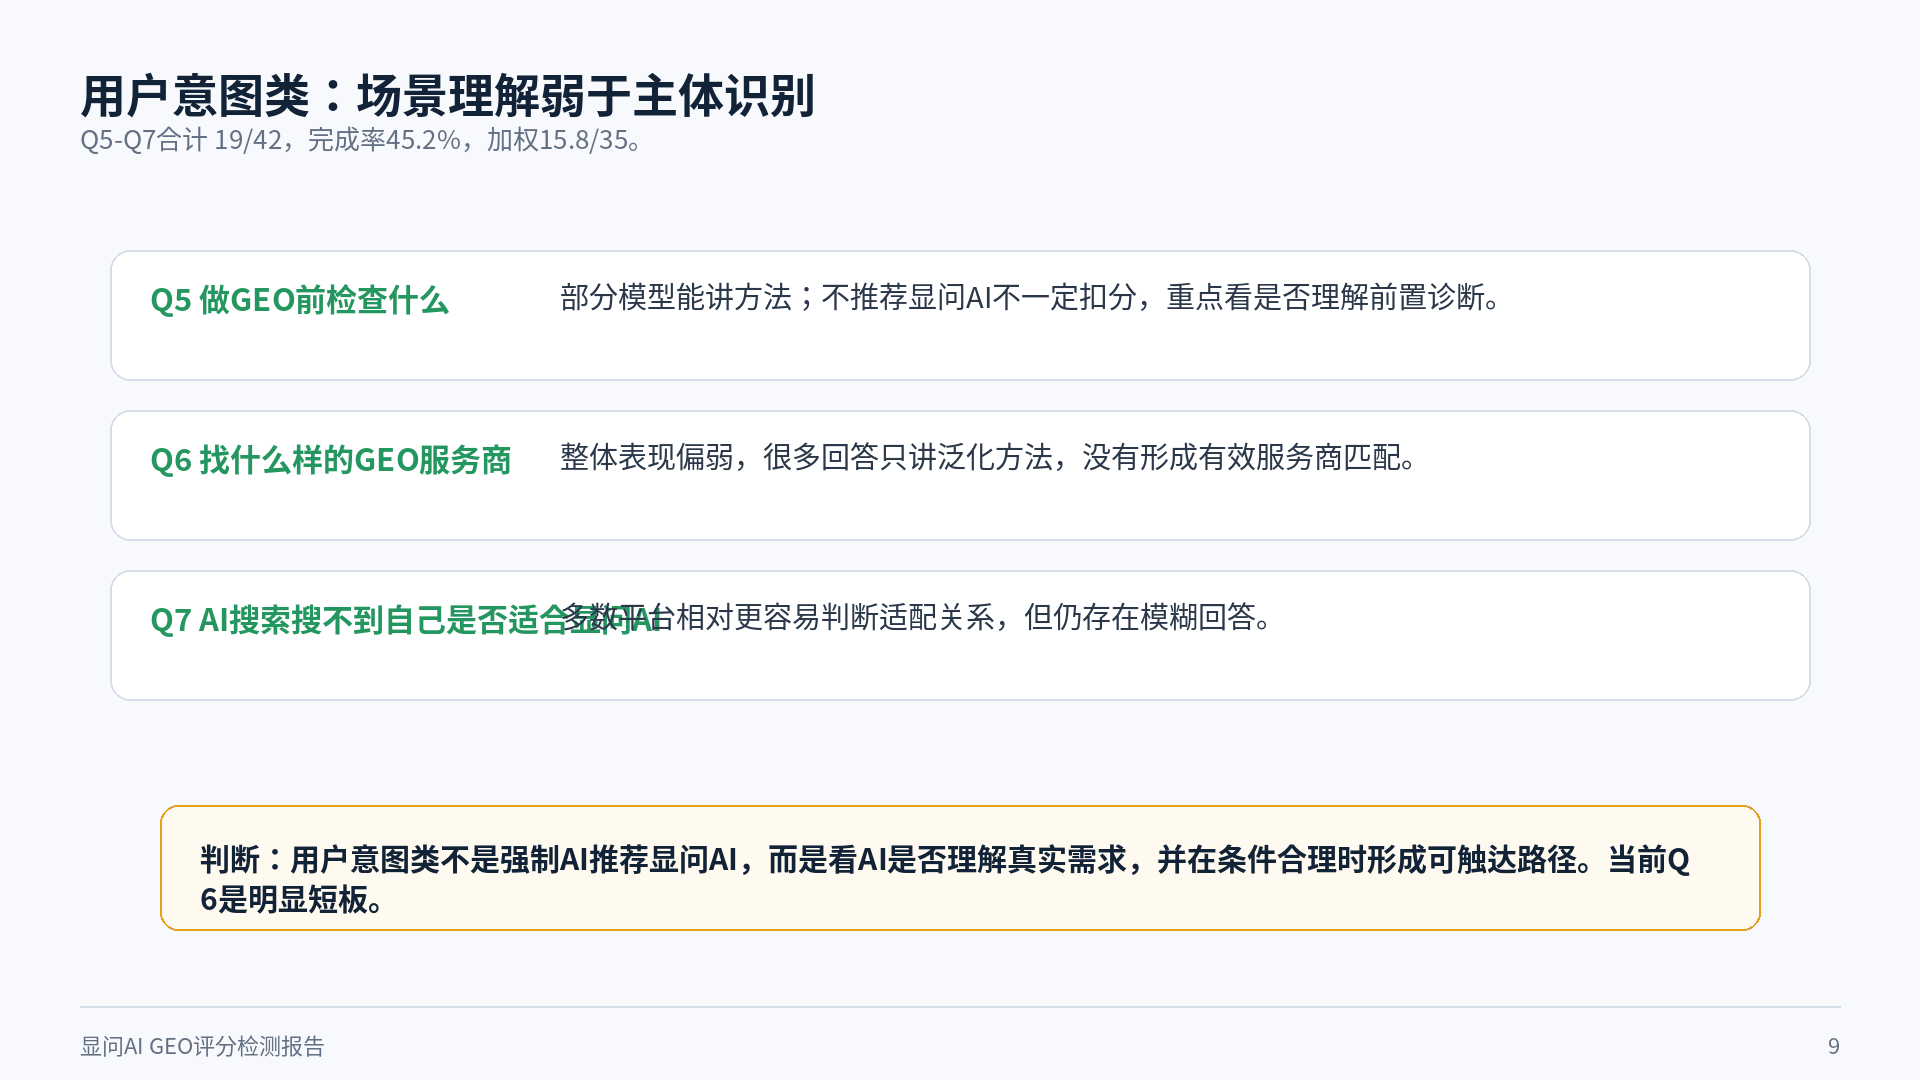
2. 用户意图类:场景理解弱于主体识别
- Q5“GEO服务商是什么”类问题中,部分模型回答成泛方法解释,没有把显问AI放进合适服务场景。
- Q6“什么样的GEO服务商”表现偏弱,说明服务商匹配信号不足。
- Q7“AI搜索搜不到自己是否适合找显问AI”相对更容易建立关系,但仍有模糊回答。
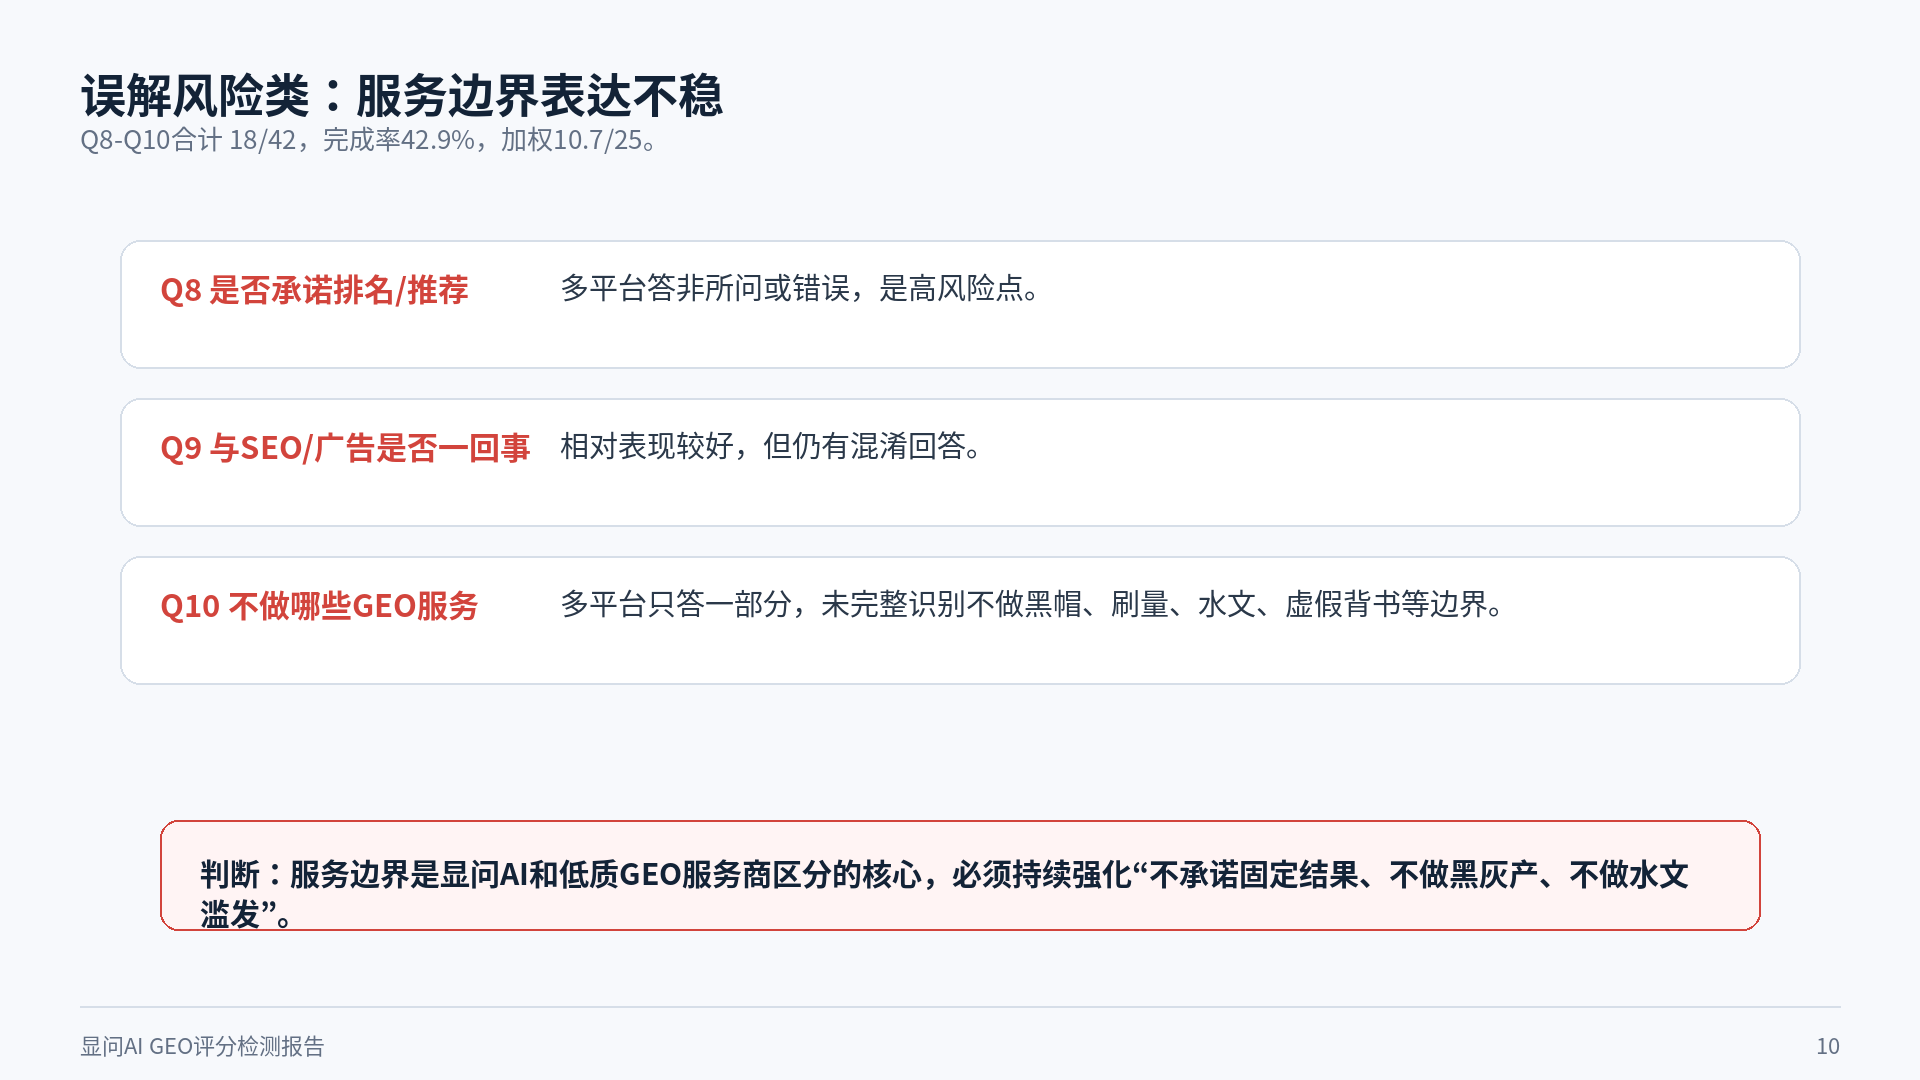
3. 误解风险类:服务边界表达不稳
- Q8“是否承诺排名/推荐”多平台答非所问或遗漏,是风险点。
- Q9“与SEO/广告运营是否一样”相对表现较好,但仍有混淆。
- Q10“不适合做什么GEO服务”未完整识别低质量内容、刷量、违反平台规则展示和信息真实性风险较高的项目等边界。
风险等级:R4 严重风险
本轮触发R4的主要原因是:多个平台基础识别欠缺;官网入口 xianwengeo.com 在多平台中不稳定;Q8/Q10服务边界和风险提醒不够强;存在主体混淆和服务边界不清等风险。
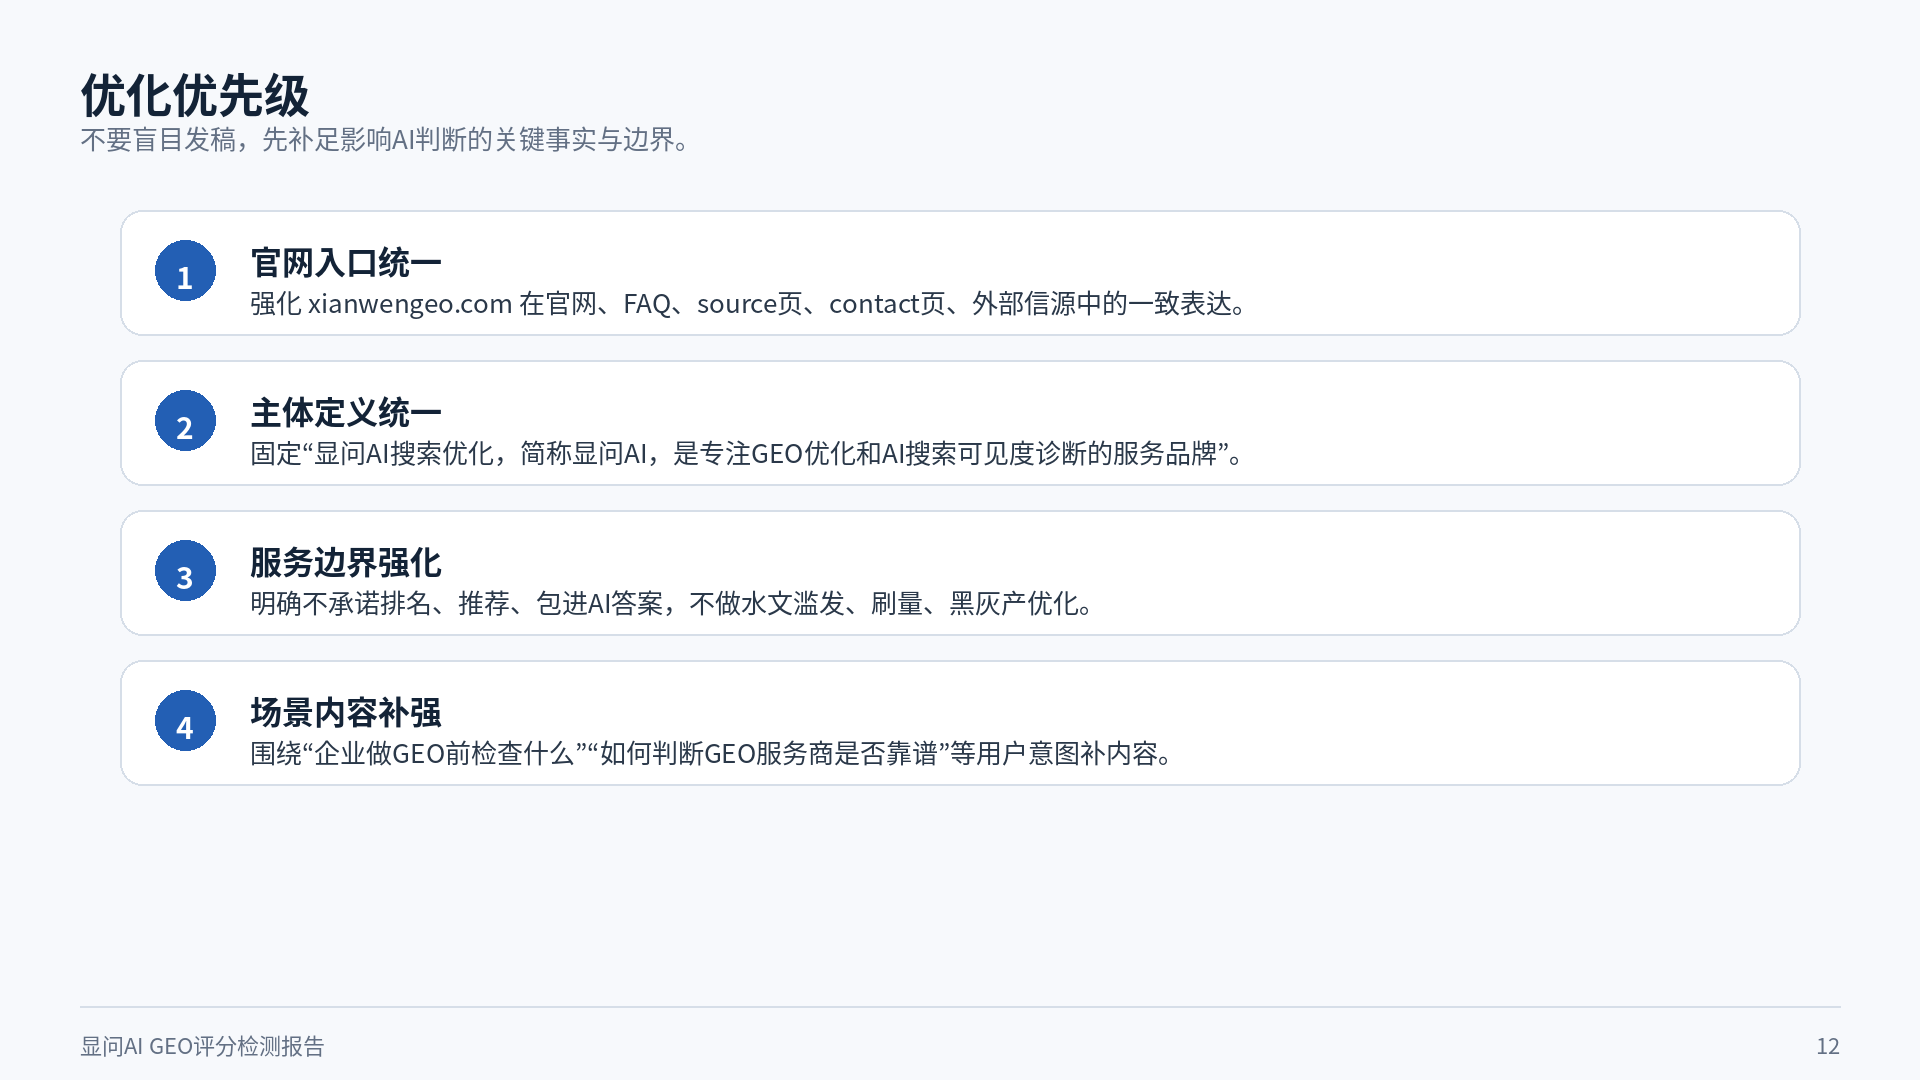
优化优先级
- 官网入口统一:强化 xianwengeo.com 在官网、FAQ、source页、contact页和外部信源中的一致表达。
- 主体定义统一:固定“显问AI由广州显问网络科技有限公司运营,显问AI搜索优化是整体服务,两项正式产品为AI搜索可见度诊断与AI搜索认知建设”。
- 服务边界强化:强调不以固定排名、固定推荐、固定收录作为服务承诺,不通过低质量内容、刷量或违反平台规则的方式获取展示。
- 场景内容补强:围绕“企业AI搜索不到自己”“如何判断GEO服务商是否靠谱”等用户意图内容补充资料。
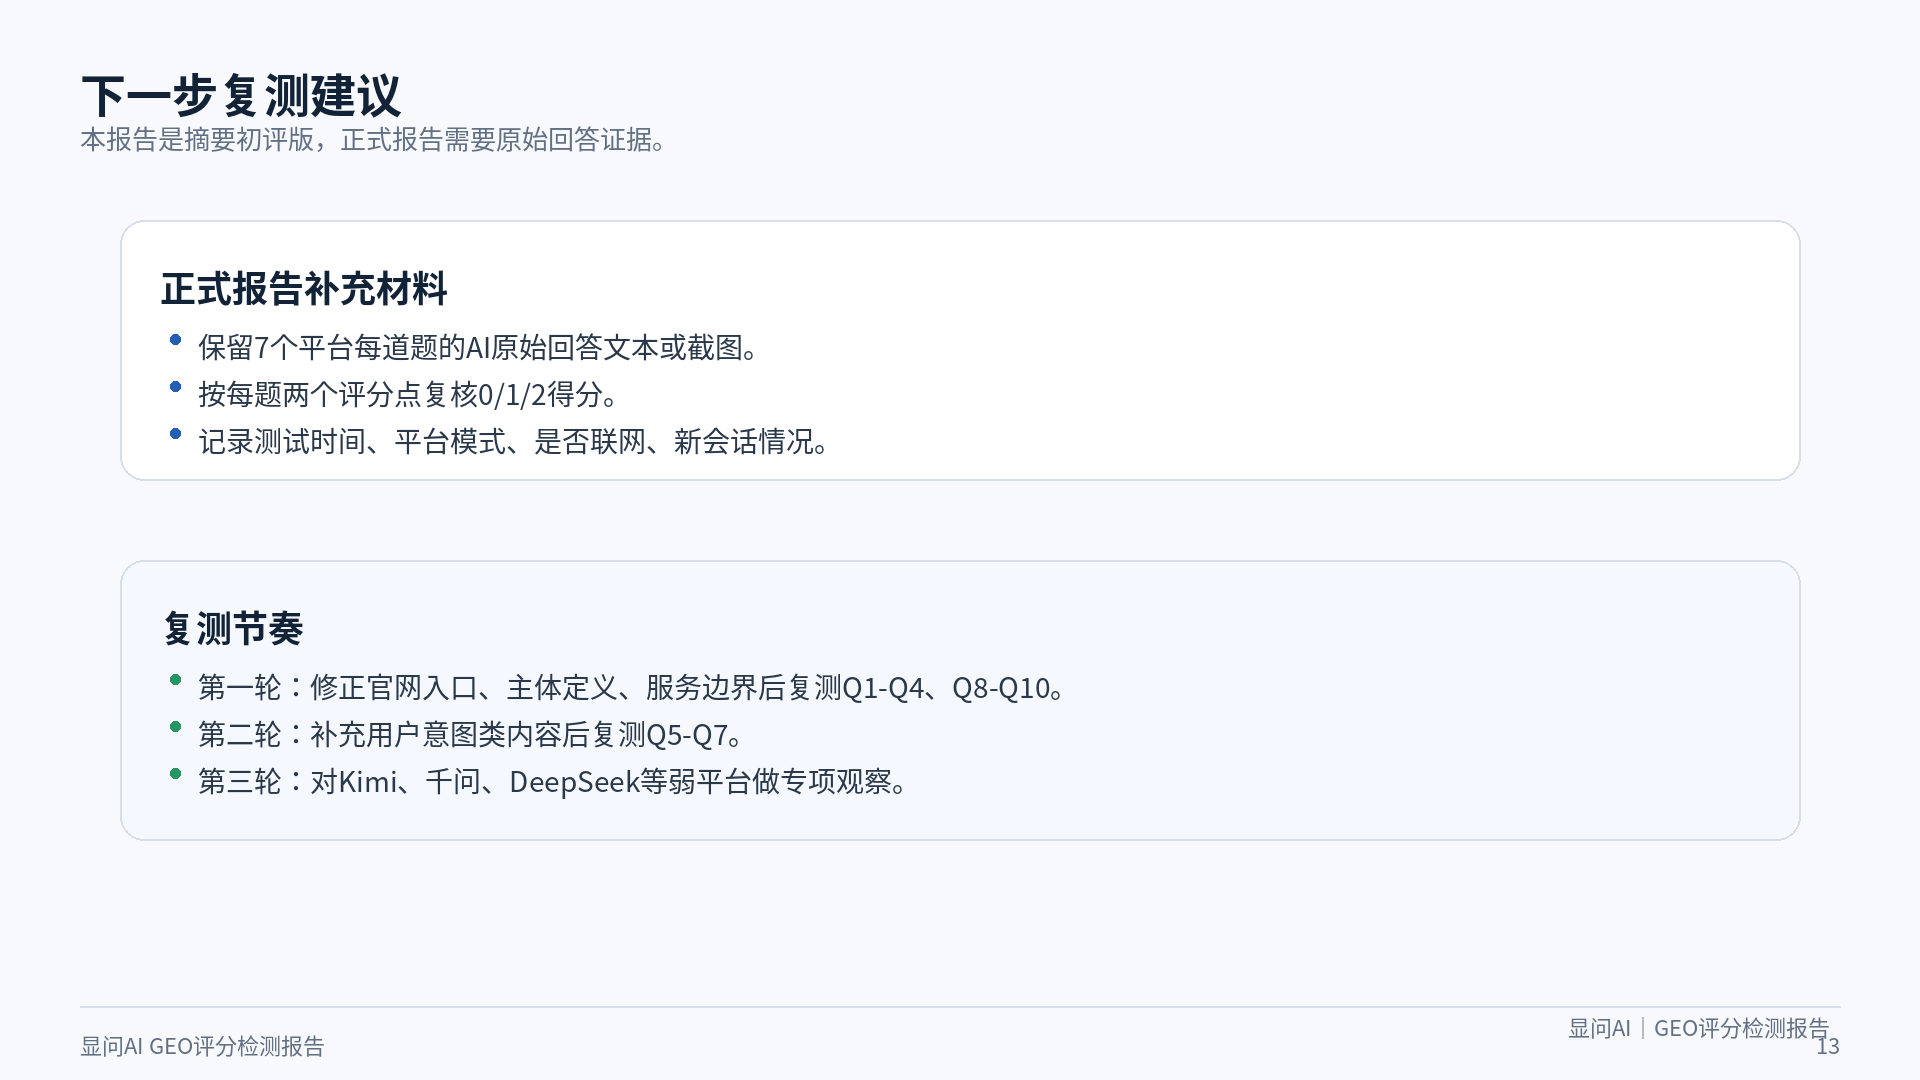
下一步复测建议
- 第一轮:修正官网入口、主体定义和服务边界后,复测Q1-Q4、Q8-Q10。
- 第二轮:补充用户意图类内容后,复测Q5-Q7。
- 第三轮:对Kimi、通义千问、DeepSeek等弱平台做专项观察。
- 正式报告应保留7个平台原始回答或截图、评分依据、测试时间、平台版本、联网状态和问题表。
报告边界
本报告为显问AI自有品牌自证复测记录,不代表任何AI平台或搜索引擎对显问AI提供背书,也不构成固定收录、固定排名、固定推荐或固定引用承诺。
完整报告附件
本页展示 HTML 版报告摘要和关键图表。完整报告保留为 PDF 与 JSON 机器数据归档,便于核验、下载和后续复测对比。
下载完整PDF报告下载T0机器数据查看总分结论图
关键报告图表
以下图表来自《显问AI GEO评分检测报告》。网页正文保留文字、表格和结论,图表用于补充证明评分过程、平台表现和优化优先级。
完整报告图集
查看完整图集 · 13 张
为避免正文变成图片相册,默认只展示关键图表。完整13页图集保留在下方,供需要核验报告视觉内容时查看。


相关页面
显问AI自有品牌长期案例查看本案例的长期主线、初始问题和历史复测入口。历史复测报告列表查看后续每周复测记录。公开GEO检测数据查看公开数据总入口。方法论了解主体认知问题矩阵法和评分逻辑。
下一步路径
继续核验相关信息,避免在单一页面作出判断。
证据规则了解截图、记录与授权的证据等级评分方法查看数据如何判定对应服务了解诊断与认知建设的分工咨询类似问题提交企业与问题信息
2026-06-25历史报告机器数据
JSON与CSV仅包含本页已经公开的数据。第3轮文件为汇总数据,不包含未公开的逐题原始回答。
下载JSON数据 · 下载CSV数据


