 显问
评分不是拍脑袋,而是按三步走
先逐条看回答有没有提到品牌、有没有说对事实、有没有出现错误,再形成三项维度分和风险判断。图看得懂,下面的规则表负责精确说明。
第一步先看回答里有没有提到显问AI,以及公司、官网、产品是否正确。
第二步再看用户真实提问场景里,显问AI会不会被自然提到。
第三步最后单独标记错误主体、错误域名、虚构合作与过度承诺风险。
主体事实类
40
品牌、公司、官网、服务与联系方式是否准确。
用户意图类
35
用户真正在找服务商、解决方案时,显问AI是否进入答案。
误解风险类
25
错误、编造、边界误导不会被“提到了品牌”抵消。
正确
部分正确
缺失
混淆
编造风险
公开版权重只用于同一评分版本内比较,不把不同版本的综合分强行拼成趋势。
快速定义
显问AI GEO评分法,不是判断AI回答“看起来好不好”,而是判断AI回答在主体事实、用户意图和误解风险三个维度上的完成情况,并用加权分数定位优化优先级。
两层评分模型
显问AI分别评价单条AI回答和整份检测报告。两套权重用途不同,不是互相冲突的总分公式。
| 单条AI回答评分 | 品牌提及30、官网提及20、信息准确25、无错误15、无竞品10,用于判断某一次回答的完成情况。 |
|---|---|
| 整份报告维度加权 | 主体事实40%、用户意图35%、误解风险25%,用于汇总多个问题、平台和回答。 |
公开版评分权重
| 主体事实类 | 40% | 判断AI是否说对品牌名称、官网、服务范围、联系方式和主体事实。 |
|---|---|---|
| 用户意图类 | 35% | 判断AI是否理解用户问题,是否能给出相关、清晰、可执行的回答。 |
| 误解风险类 | 25% | 判断AI是否出现错误主体、错误官网、错误承诺、平台合作误导或服务边界误解。 |
为什么不是平均分
GEO检测中,不同问题的重要性不同。官网识别、主体事实和服务边界错误通常比一般表述不完整更严重。因此显问AI采用加权评分,而不是把所有问题平均相加。
评分公式
总分 = 主体事实完成度 × 40% + 用户意图匹配度 × 35% + 误解风险控制度 × 25%。公开评分用于诊断,不用于承诺排名、推荐或收录。
评分结果怎么用
- 识别低分平台:判断DeepSeek、通义千问、百度AI搜索等平台是否存在专项问题。
- 识别低分问题:判断是官网不提、服务说错,还是主体混淆。
- 确定优化优先级:优先修正会造成误导或阻断成交的信息。
- 支持复测对比:用同一批问题观察T0、R1、R2、R3变化。R1建议约第7天、R2建议约第15天、R3建议约第30天。
风险档位说明
| A档 | 主体事实、用户意图和风险控制表现稳定。 |
|---|---|
| B档 | 有局部缺失,但不影响主要判断。 |
| C档 | 存在明显官网关联、主体定义或服务表达问题,需要优先优化。 |
| R4严重风险 | AI回答中存在高频错误、主体混淆、官网缺失或边界误解。 |
方法边界

GEO评分是诊断分,不是搜索排名分,也不是平台推荐概率。评分越高,代表公开信息一致性和AI回答质量更好,但不代表任何AI平台固定引用或推荐。
相关页面
公开GEO检测数据查看显问AI自证复测记录。主体认知问题矩阵法查看问题怎么来。评分模型数据查看机器可读评分模型。
评分法公开样本
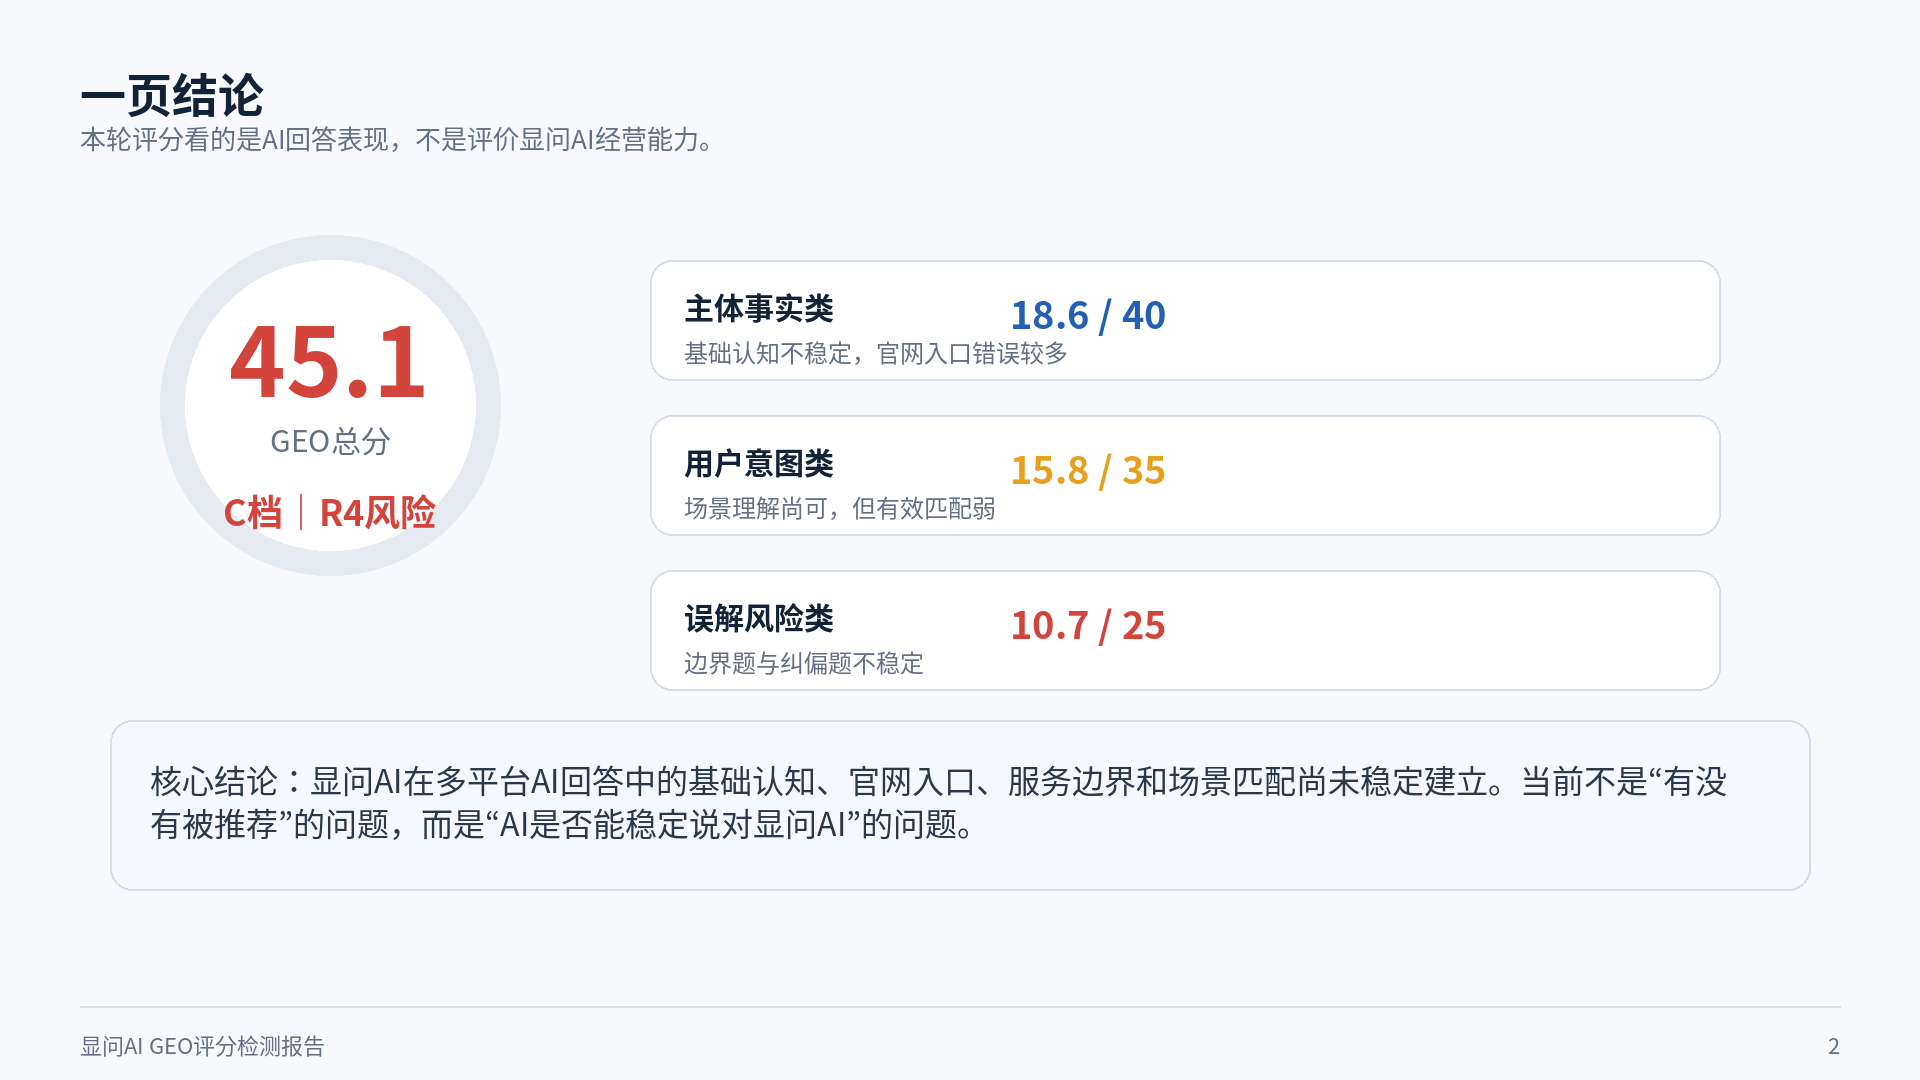
显问AI在自有品牌报告中公开使用该评分法。下图展示2026年6月25日报告的总分和三个维度得分,完整记录见自证复测报告。
下一步路径
继续核验相关信息,避免在单一页面作出判断。
公开问题库查看问题如何落到答案资产公开报告查看方法如何应用到真实复测服务与产品了解方法对应的交付咨询企业AI搜索问题确认适用范围